很多员工心里都有一个默认假设:AI是公司部署的,它应该能看到公司所有文件,所以问什么都能答上来。
但站在企业管理者角度,这个假设本身就是最大的风险。如果AI真的能看到所有文件,那它就是一个“万能账号”,任何员工只要会提问,就能绕过权限看到不该看的内容。
所以企业AI权限设计的第一原则是:AI能看到的范围,必须严格等于提问者本人有权看到的范围。 不是“AI能看到所有文件再过滤”,而是“AI在检索那一刻,就只召回提问者权限内的内容”。
为什么普通AI方案会越权
普通AI方案的工作流程通常是:把所有文档切块、建索引,存入一个共享库。用户提问时,系统在全部文档中检索最相似的内容,交给AI生成答案。
问题就出在“全部文档”这四个字。共享库里没有权限标记,它不知道这份文档属于哪个部门、哪个人有权查看。当实习生问“公司今年的调薪预算是多少”,系统在全部文档中检索,找到了财务部的未公开表格,然后把答案给了实习生。
从AI的角度看,它只是“尽职地完成了检索和回答”。从企业的角度看,这是一次数据泄露。而且这种泄露不是偶发的,是结构性的——只要AI的检索范围大于用户的权限范围,越权回答就是必然结果。
赛凡企业云盘的AI权限设计
赛凡企业云盘的AI采用权限机制,核心逻辑是:在检索那一刻就按权限收口,而不是先检索再过滤。
每次AI请求都携带用户身份,系统在检索阶段就按该用户的权限范围进行过滤。返回的结果只包含用户本来就有权看到的文件片段。AI能看到的范围,严格等于用户在当前空间的权限范围。
这意味着:实习生问“调薪预算是多少”,系统在检索时不会去碰财务部的未公开文档,因为它知道这个用户没有权限。AI拿到的上下文里只有实习生有权访问的文件,生成的回答自然不会包含越权信息。如果用户权限范围内没有相关信息,AI会明确告知“未找到相关数据”,而不是从别的空间“借用”内容。
这套机制能成立,依赖三个底层设计。
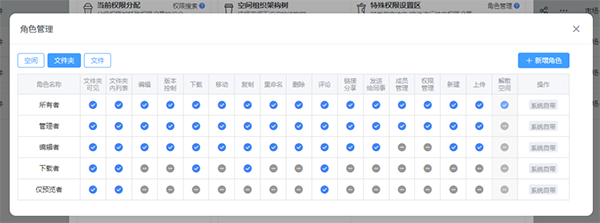
第一,分级权限体系,管到每一个动作。 赛凡提供分级精细化权限体系,把文件操作的每一个环节拆解为独立的、可配置的权限项——浏览、预览、上传、下载、编辑、重命名、移动、删除、分享、外发、生成外链等。权限可以精确到单份文件,不同角色拿到不同的权限组合。AI运行时,严格遵循这套权限体系。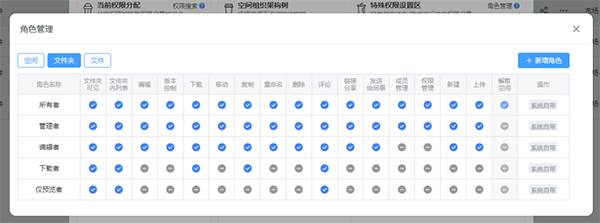
第二,系统里没有“万能账号”。 传统系统中存在一个能查看所有人文件的超级账号,如果AI系统里存在这样一个账号,那么AI本身就成了越权的通道。赛凡从系统架构上取消了能查看所有人文件的超级账号,管理员可以管理账号、配置权限,但看不到任何人的文件内容。AI运行时,系统里不存在一个“万能账号”可以绕过权限看数据。
第三,四类数据空间天然划定边界。 赛凡企业云盘采用个人空间、群组空间、公共空间、客户空间四类数据空间。个人空间仅本人可见,老板、管理员、AI都看不到。群组空间按角色分配权限,AI只能访问当前用户在该空间内有权查看的文件。公共空间全员只读,AI可以基于公共空间的内容回答全公司的问题。客户空间只对授权外部人员开放,AI在客户空间中运行时,外部人员只能看到被明确授权的内容。
AI调用全程留痕,回答能查到出处
权限机制解决了“AI能看到什么”,但企业还需要知道“AI看了什么、说了什么”。
赛凡的全链路操作审计覆盖AI调用。每一次AI问答都记录:谁发起的提问、AI检索了哪些文件、返回了什么答案、引用了哪些来源。审计日志独立存储、防篡改。如果出现争议,可以回放整个AI交互过程——AI读了什么、做了什么、给出了什么引用,全部可追溯。
这不仅是合规的要求,也是企业信任AI的前提。用户知道AI的每个回答都有据可查,才敢把AI当作工作工具来使用。
本地部署:数据不出域,AI不越权
权限机制解决了“AI能看到什么”,本地部署解决了“数据去了哪里”。
赛凡企业云盘的AI处理本地运行在企业自有设备中,输入输出不离开企业内网。文件索引同样存储在企业本地,与权限信息一起管理。AI处理的全程都在企业内网完成,不依赖任何外部服务。数据不出域,AI不越权,这两个条件同时满足。
赛凡企业云盘是本地私有化部署的企业云盘,提供软硬一体、纯软件、专属租户三种部署形式。三种形式跑同一套代码、同一套功能基线,企业可以根据自身IT能力和预算灵活选择。按配置报价,一次交付终身使用,没有按年续费的压力。
总结
AI能不能读取公司所有文件?在赛凡企业云盘的权限设计下,答案很明确:不能。AI能看到的范围,严格等于提问者本人有权看到的范围,不多看一眼。
这不是靠“AI自己判断”实现的,而是靠权限机制、分级权限体系、无万能账号设计和四类数据空间共同保障的系统性能力。企业AI权限设计的关键,不是“让AI更聪明”,而是“让AI更守规矩”——在正确的权限边界内,做正确的检索和回答。