AI知识库私有化部署怎么做?企业落地前要核对的5件事
AI知识库私有化,就是把文件、向量索引和大模型推理都放在企业自己的服务器或私有云里,AI只基于内部资料回答,数据不经过第三方平台。要让私有化部署的企业知识库真正可用,还得把权限、审计和运维一起解决。
一、什么是AI知识库私有化
企业常说的AI知识库,多数是检索增强生成(RAG)的做法:先把文档切分并转成向量建立索引,员工提问时系统检索出相关片段,再交给大模型组织成答案。这个过程中有三类数据在流动:原始文件、向量索引,以及提问内容和检索到的片段。
所谓私有化,是这三层都运行在企业指定的环境里:文件存储在本地,向量索引建在本地,大模型推理也在本地完成。如果只做了其中一层,比如文件放在公司服务器上,回答却调用外部大模型接口,那么员工的提问和检索出的文件片段,仍然会发送到企业边界之外。
会计和税务事务所、律师事务所、制造企业、工程设计单位,以及政府、金融、医疗等机构,手里多是客户资料、合同、图纸和工艺文件,对保密有明确要求,通常会优先考虑私有化方案。
二、数据和模型:先问清"放在哪"和"用什么"
第1件事,核对数据位置。选型时请供应商逐层说明:文件、向量索引、模型推理、访问日志分别存放和运行在哪里,有没有任何环节调用外部接口。"支持私有化"是一句笼统的话,要落到这几层逐一确认。
第2件事,核对模型方案。开源大模型可以在本地运行,例如Qwen、Llama、DeepSeek等系列。需要确认的是:方案能否按需更换模型,是否适配国产芯片和操作系统,硬件由谁来评估。硬件配置和用户规模、文档量、并发量直接相关,应当按企业实际情况评估,不要套用网上的通用配置单。
三、权限和审计:AI能看到的,不能比提问的人多
第3件事,核对权限继承。私有化部署常见的风险,是把全公司文档放进同一个索引,结果普通员工随口一问,就拿到了自己本来无权查看的合同、报价或人事资料。要确认AI检索时是否按提问人的文件权限过滤结果,文件权限调整后索引能否同步生效。
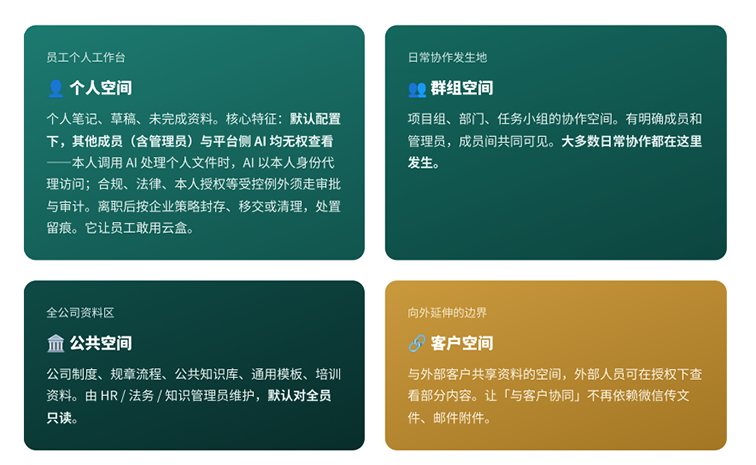 赛凡智云四类数据空间:个人、群组、公共、客户空间的权限边界" data-href="" style=""/>
第4件事,核对审计留痕。谁在什么时间问了什么、AI引用了哪些文件、相关文件有没有被外发,都应当可以追溯。对事务所和律所来说,这些记录也是向客户说明保密措施时的依据。
另外,建议要求回答附带引用出处。员工能直接点开原文件核对,就不容易把AI生成的内容当成结论直接使用。
四、上线和运维:不要只看演示效果
第5件事,核对资料基础和运维责任。知识库的回答质量,取决于文件是否集中、目录是否清楚、权限是否理顺。如果资料还散落在个人电脑、聊天软件和U盘里,应当先把文件收拢到统一的存储中,再接入AI。
运维方面,模型升级、索引重建、备份容灾、出现问题由谁响应,都要在选型阶段问清楚,并写进交付约定。
落地节奏上,可以先选一个部门、一类资料试点,确认回答质量和权限边界都符合预期,再逐步扩大范围。
五、赛凡智云怎么做AI知识库私有化
赛凡智云的思路是先有私有云盘底座,再接AI。企业文件统一存放在私有化部署的云盘里,权限可以细到人和文件,AI问答和检索都建立在这套权限之上,按当前操作者的可见范围返回结果。
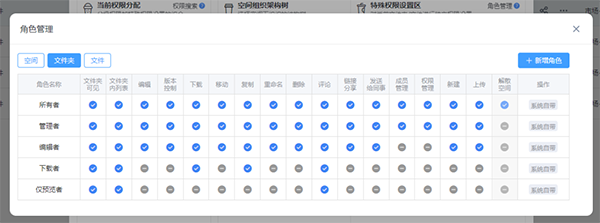
文件、向量索引和AI推理都在企业指定的环境内运行,支持Qwen、Llama、DeepSeek等开源大模型私有化部署,访问和外发行为可审计,并支持国产化适配。
已经在用文件服务器或NAS的企业,可以先评估现有目录和权限怎么迁移,再规划AI能力的上线顺序。
想知道你们的资料适不适合做私有化AI知识库?
可以预约赛凡智云产品演示。我们会用贴近你们业务的文件场景,演示AI如何在权限边界内检索和回答,并结合你们的部署环境做初步判断。