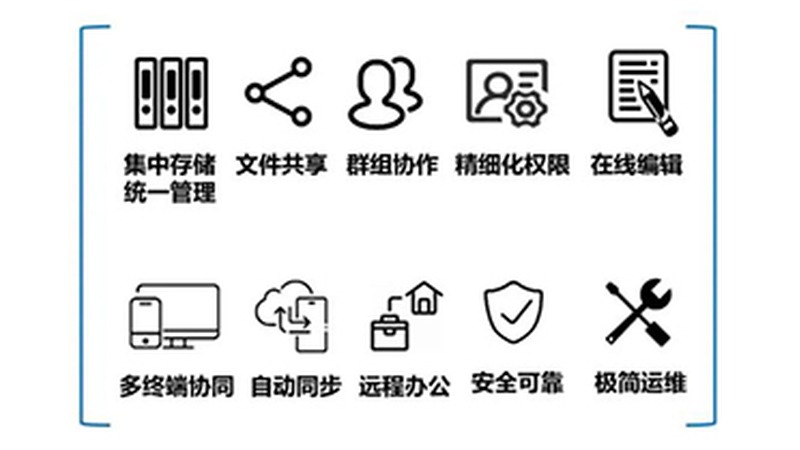
企业文件接入AI知识库,建议先把散落的文件收拢到一个有权限管理的云盘里,再让AI在这个文件库上建索引、做问答,并沿用原有的文件权限。这样搭出来的私有化智能问答,答案能追溯到原文,AI检索按员工的文件权限过滤。
一、为什么要从文件库出发,而不是另建一个知识库
很多企业做AI知识库,起步时会挑一批文档整理好,单独导入一个新系统。问题在于,日常工作中的文件仍在共享盘、网盘和个人电脑上不断产生和修改,单独导入的那一份很快就和实际文件对不上。
另一个问题是权限。单独导入的知识库往往只分"能用"和"不能用"两档,原来文件上的部门、项目权限丢了,结果要么只敢放公开资料,要么出现员工通过问答看到不该看的内容。
从企业正在用的文件库出发,文件在哪里改,AI就在哪里检索,权限也沿用文件库里已经设好的那一套,后续维护集中在一处。
二、先把散落的文件收拢到一个文件库
盘点文件现在分布在哪里:文件服务器、NAS、各部门共享盘、员工个人电脑、聊天软件里的附件。确定哪些资料要进知识库,比如制度流程、项目文档、合同模板、技术资料、历史方案,哪些暂不纳入。
迁移时尽量保留原有目录结构,文件历史版本和权限能否随迁移带过来需专项评估;同时清理重复文件和明显过期的版本。重复和过期的文件留在库里,AI检索时会把它们一起找出来,回答就容易前后矛盾。
扫描件、图片型PDF要单独标出来,后续需要做文字识别才能被检索到。
三、理清目录和权限:AI检索的边界就在这里
收拢之后,按部门、项目、客户整理目录,再按角色分配权限。这一步决定了AI问答的边界:员工通过AI能看到的内容,应当与他本来有权打开的文件一致。
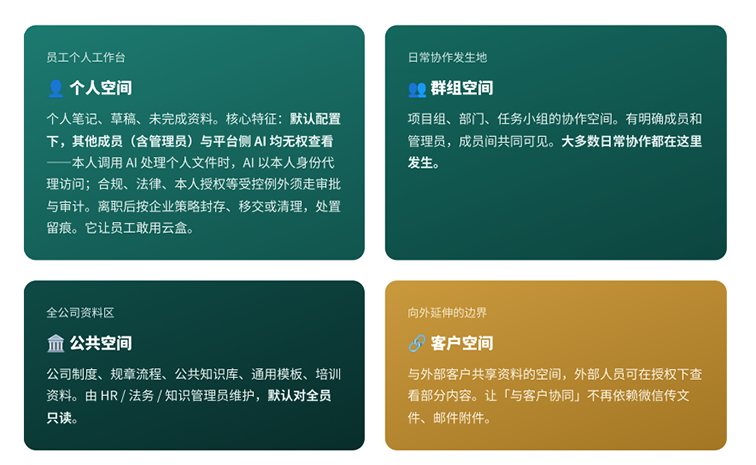
要特别检查几类情况:多年累积、无人维护的共享目录,临时加给个人后忘了收回的权限,离职和调岗人员的残留权限。这些问题在没有AI时不明显,接上AI后会被放大,因为问答会把分散在各处的内容一并找出来。
上线前,用几个不同权限的账号问同一个问题,确认答案和引用的文件都在各自的权限范围内。
四、接上AI:索引、问答和引用溯源
文件库整理好之后,系统对文件做解析、切分和向量索引,员工提问时先检索相关段落,再由部署在本地的大模型组织答案。模型和索引都放在企业环境里,提问和文件内容不会发到外部服务。
答案要附带引用出处,员工可以点开原文核对,而不是直接相信AI的结论。每一次问答和检索都应留下记录,便于追溯,也便于发现哪些问题答得不好、对应的资料需要补充。
选型时还要问清楚:文件修改、删除或权限调整后,索引和检索范围多久跟着变化,是否需要人工重建。这关系到上线后知识库能否一直和实际文件保持一致。
五、赛凡智云的做法:云盘在前,AI在后
赛凡智云先提供私有化部署的企业私有云盘作为文件底座,把企业文件集中存放、按人和文件分配权限,再在此基础上接入AI能力,模型与数据都在企业内网。按官网的能力分级,文件问答与检索属于已上线能力,适用版本和部署条件以产品方确认为准。
员工用AI提问时,检索范围按他在云盘里的文件权限过滤;AI问答、引用和检索过程都有记录可查。模型方面,支持Qwen、Llama、DeepSeek等开源大模型私有化部署。
部署前要核对的事项和知识库的组成部分,可以参考《AI知识库私有化部署怎么做?企业落地前要核对的5件事》和《本地部署AI知识库需要什么?私有化方案的组成与搭建步骤》两篇。
想看看你们现有的文件接上AI问答是什么效果?
可以预约赛凡智云产品演示。我们会结合你们现有的文件分布和权限情况,演示从文件收拢、权限设置到文件问答的实际流程,并帮你评估哪些资料适合先接入。