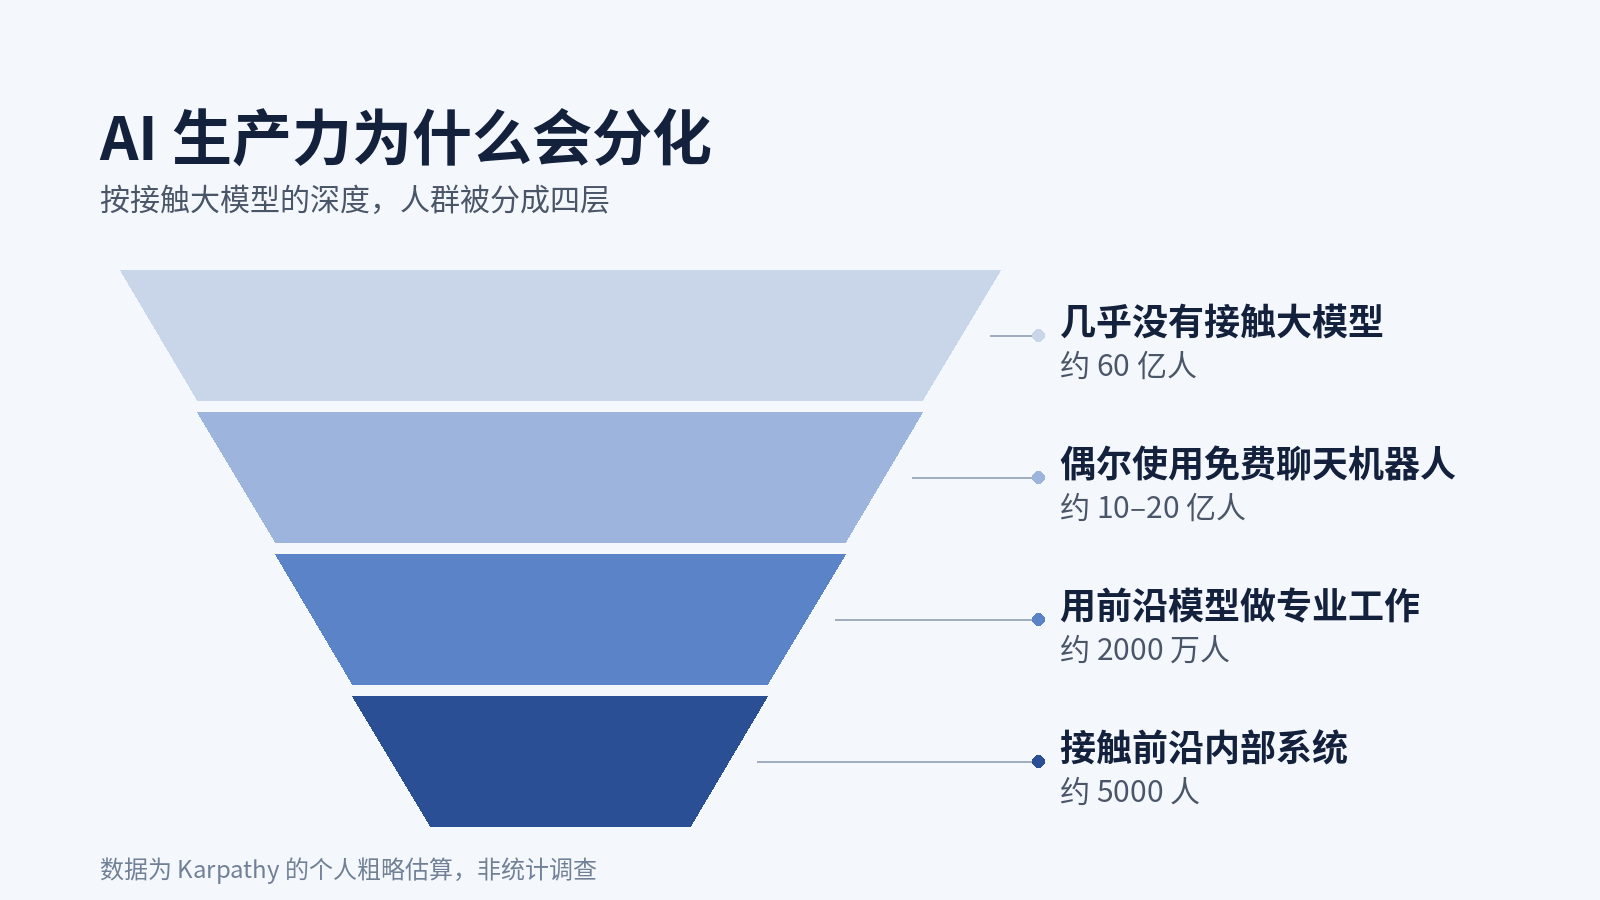
AI 带来的分化,正在从信息差变成生产力差:同样能用上大模型,有人只用它回答问题、写邮件,有人已经让它连续数周推进完整的软件项目。决定差距的,不只是用没用 AI,而是能不能把模型能力变成真实产出。Andrej Karpathy 近期用一组粗略估算,描述了这种 AI 使用深度的分层。
一、Karpathy 的四层估算
据 AI FrontPage 报道,Karpathy 在 2026 年 10 月 11 日的一条帖子里更新了他此前的一个判断,用他自己称为"粗略估算"的方式,把人群按接触大模型的深度分成四层:
- 约 60 亿人,几乎没有接触过大模型;
- 约 10 亿至 20 亿人,偶尔使用免费的聊天机器人;
- 约 2000 万人,在数学、代码等专业工作中使用前沿级别的大模型;
- 约 5000 人,能接触到前沿级别的内部系统。
这几层人生活在同一个时代,用到的技术却像隔了几代。他形容处在顶层的少数人,正在体验能力曲线陡然上扬带来的眩晕感。
需要说明的是,这组数字是个人粗略估算,不是统计调查结果,适合用来理解分层的结构,不适合当作精确数据引用。
二、他认为分化来自三个因素
问题规模。用 AI 回答一个问题,和让 AI 自主推进一个持续两周的软件项目,考验的不是同一种能力。问题越小,越看不出模型之间、用法之间的差别。
能力分布不均。模型的能力并不是在所有领域同步提升,进步集中在数字化、结果容易验证、又有经济价值的领域,代码和数学是典型。在这些领域之外,体验可能完全不同。
访问权限。免费版、付费版和实验室内部系统,能体验到的能力并不一样。
三、模型能力不等于真实生产力
以下是在 Karpathy 观点基础上的几点延伸看法,属于观点和推断。
同样的模型,有人用来写邮件,有人用来开发完整的软件。差别不只在提示词,而在于有没有合适的任务、工具、执行框架和验证闭环,把模型能力真正释放出来。
真正稀缺的也不是提示词,而是高质量的问题。没有足够复杂、真实、值得解决的问题,再强的模型也很难发挥出来。个人能从 AI 获得多大杠杆,很大程度上取决于能提出什么问题,以及能否判断什么才算解决了问题。
四、能被验证的工作,会先被改造
代码和数学进展快,一个重要原因是结果容易验证:程序能不能跑、测试过没过、证明对不对,都有明确的判断标准。一个行业能在多大程度上被 AI Agent 改造,很可能取决于它能否建立有效的执行与反馈闭环。
这也带来一个新的瓶颈。当生成变得越来越容易,审核就成了卡点:Agent 可以很快生成代码、方案甚至研究结论,但谁来判断它们是否正确?生产速度一旦超过验证速度,就会积累大量没人核过的结果。因此,评估和验证机制会逐渐从附加功能变成 Agent 系统的基础设施。
五、人的工作重心正在转移
以软件开发为例,过去开发者要亲自完成规划、编码、测试和修复;现在越来越多的执行环节可以交给 Agent,人的重心转向定义目标、设计系统、管理约束和验收结果。
这种差距还可能是复利式的。有人只用 AI 提高手头任务的效率;有人用 AI 完成更多项目,积累经验,再反过来改进自己的工作流。时间一长,两者之间的距离可能越拉越大。
六、边界与限制
本文的数据部分只来自 Karpathy 的个人估算,不代表任何机构的统计;第三至第五节是基于其观点的分析,属于推断,不同行业、不同岗位的实际情况会有差别。对多数企业来说,更现实的问题不是追赶顶层的少数人,而是先找到一两件能被验证的真实任务,让 AI 在里面跑通。
企业想让 AI 用在自己的文件和业务上,从哪里开始?
可以从一类边界清楚、结果可核对的任务入手,比如基于内部文件的检索和问答,同时提前考虑数据放在哪里、谁能看到什么。相关思路可参考AI知识库私有化部署和私有化 AI 与数据不出域方案,也可以预约赛凡智云的演示,结合你们的场景具体沟通。